Graph Engineering mit KI: Ein Fall aus dem eigenen Betrieb
Graph Engineering mit KI ist derzeit ein absoluter Hype-Begriff in der KI-Welt. Dieser reale Fall dokumentiert jedoch: Daran ist nichts Mystisches und es hat rein gar nichts mit Raketenwissenschaft zu tun. Es ist schlicht die Art, wie man heute einen KI-gestützten Ablauf baut, der unbeaufsichtigt laufen soll.
Graph Engineering klingt zunächst nach einer Werkzeugkategorie. Tatsächlich ist es eine präzise Zerlegung: Arbeit wird in einzelne Schritte geschnitten, Übergänge werden als logische Bedingungen formuliert und der Zustand wird explizit gespeichert. Das Ergebnis ist ein klar definierter Graph aus Knoten und Kanten.
Der wahre Nutzen zeigt sich erst in der Frage, die sich ohne diese Zerlegung gar nicht stellen lässt: Welcher Knoten braucht tatsächlich einen KI-Agenten und welcher nicht? Diese Antwort entscheidet über Kosten, Laufzeit und die Verlässlichkeit eines unbeaufsichtigten Ablaufs.
Ein Praxisbeispiel aus dem eigenen Haus zeigt, wie das funktioniert: Ein Prozess, der seit dem 2. Juni 2026 im Einsatz ist und seit dem 26. August zweimal täglich selbstständig publiziert.
Der Fall
Die KI-News-Seite von iconference.ch wird nicht manuell gepflegt. Die Quellenliste umfasst 40 Einträge, und sie zerfällt in zwei Gruppen, die auf verschiedenen Wegen hereinkommen.
21 Quellen liefern einen RSS- oder Atom-Feed, darunter OpenAI, Google DeepMind und mehrere Schweizer Fachmedien. Diese holt ein Python-Skript deterministisch ab, mit einem Zeitfenster von zwei Tagen und höchstens fünf Einträgen je Quelle. Bereits gesehene Links fallen über eine Zustandsdatei heraus. Fällt eine Quelle aus, überspringt das Skript sie und läuft weiter.
Die übrigen 19 haben keinen Feed, etwa die News-Seite von Anthropic. Für sie legt das Skript nur einen Platzhalter mit der URL an. Geholt werden sie erst im nächsten Schritt vom KI-Agenten, der die Seite per HTTP abruft und daraus die ein bis drei neuesten Meldungen liest. Zusätzlich durchsucht er das Postfach info@iconference.ch nach Newslettern.
Aus diesen Kandidaten wählt der Agent aus und verfasst zweisprachige News-Beiträge. Danach übernimmt wieder Code: zusammenführen in eine JSON-Datei, statische Seiten bauen, committen, pushen. Zwei Minuten später ist der Inhalt online. Stand heute: 607 Meldungen aus 94 Läufen.
Knoten, Kanten, Zustand
Die Knoten sind die konkreten Arbeitsschritte: Quellen abrufen, kuratieren, publizieren.
Die Kanten sind deterministische Bedingungen, keine blossen Dekorationspfeile auf einer Präsentationsfolie. Liegt der Entwurf für einen Lauf bereits vor, bricht das Skript sofort ab. Sind die Kandidaten schon geholt, werden sie wiederverwendet statt erneut abgefragt. Jede dieser Regeln ist als klare Abfrage im Skript hinterlegt und nachvollziehbar.
Der Zustand liegt als Datei auf der Festplatte. Damit übersteht er einen Absturz. Ein abgebrochener Lauf kostet lediglich einen Neustart, aber keine verlorene Arbeit.
Welche Knoten eine KI brauchen
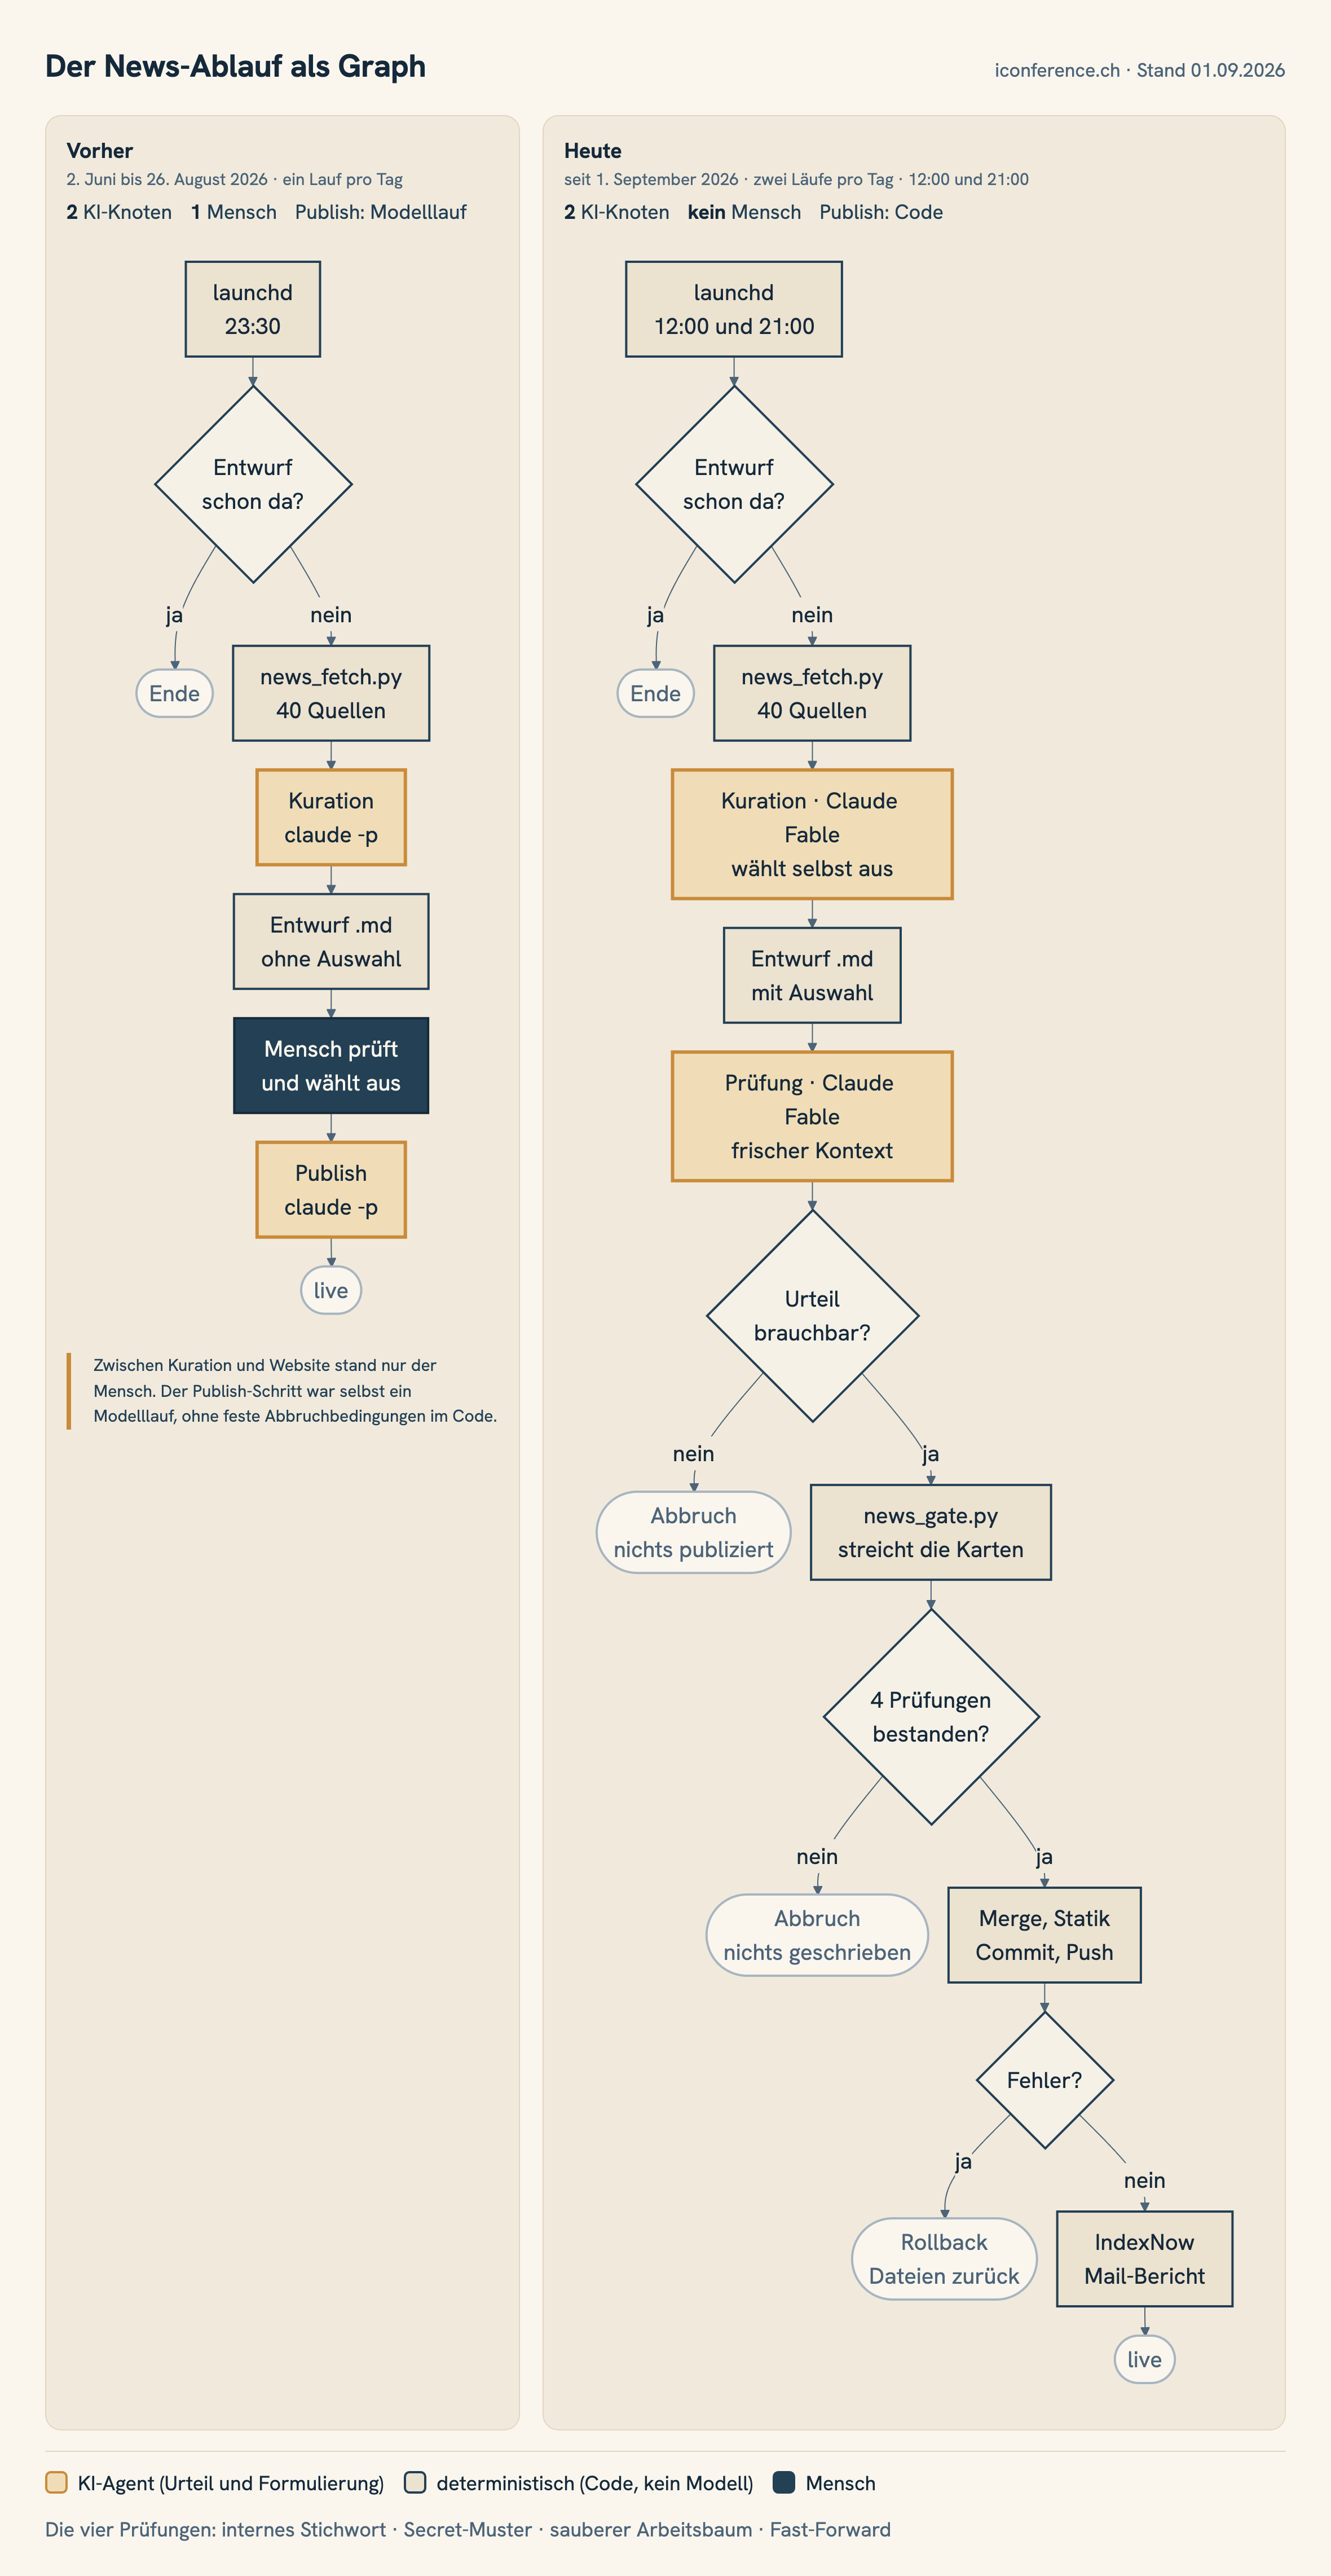
In diesem Ablauf benötigen genau zwei Knoten ein Sprachmodell, und sie tun Verschiedenes. Der erste kuratiert: Er wählt aus den Kandidaten aus und schreibt die News-Beiträge in zwei Sprachen. Für beides gibt es keine festen algorithmischen Regeln, beides erfordert Urteilskraft und Formulierungsgabe. Der zweite prüft, was der erste geschrieben hat, und darf einzelne Beiträge zurückweisen. Beide Knoten übernimmt Claude Fable mit fest definiertem Modell und stark eingeschränktem Werkzeugkasten.
Vor dem Umbau waren es ebenfalls zwei Modellläufe, aber an anderer Stelle. Der zweite schrieb damals, statt zu prüfen: Er setzte den Publish-Schritt um, ohne feste Abbruchbedingungen im Code. Die Zahl der Modellaufrufe ist heute also dieselbe wie im Juni. Geändert hat sich ihre Rolle. Das eine Modell formuliert, das andere urteilt über das Formulierte, und dazwischen steht kein Mensch mehr, sondern Python.
Der Kurations-Knoten ist zugleich die Stelle, an der fremder Text ins System kommt: Feed-Titel, Zusammenfassungen, ganze Web-Seiten, alles ungeprüft. Der Auftrag behandelt diesen Text deshalb ausdrücklich als Daten und nie als Anweisung. Der Agent befolgt keine Handlungsaufforderung aus einem News-Inhalt, und der Web-Abruf ist auf die URLs der Quellenliste begrenzt, nie auf eine URL, die im Inhalt selbst auftaucht. Ein Ablauf, der fremde Seiten liest und danach unbeaufsichtigt in ein Git-Repository schreibt, braucht diese Grenze. Ohne sie genügt ein präparierter Feed-Eintrag.
Der Prüf-Knoten liest denselben fremden Text ein zweites Mal, hat dafür aber keinen Ausgang: kein Web-Abruf, keine verbundenen Dienste, keine Shell, nur Lesen und das Schreiben seiner Urteils-Datei. Und er fasst den Entwurf nicht an. Sein Urteil setzt ein Python-Schritt um, der die Haken entfernt und den Grund einträgt. Ein präparierter Feed-Eintrag kann über diesen Knoten also höchstens einen Beitrag streichen, nie einen Text auf die Website bringen. Wer prüft, braucht weniger Rechte als wer schreibt.
Alle übrigen Knoten kommen ohne KI-Agenten aus, da sie rein deterministisch arbeiten: Feeds abholen, Dubletten gegen die letzten 14 Tage abgleichen, JSON zusammenführen, Statik erzeugen, Git-Commit und Git-Push durchführen sowie den Statusbericht per Mail versenden.
Der letzte Knoten ist neu und wirkt auf den ersten Blick wie ein typischer Fall für eine KI. Nach jedem Durchlauf wird eine System-Mail generiert: Was ging live? Welcher Commit-Hash? Wie hoch ist der Gesamtdatenbestand? Ein Sprachmodell braucht es dafür jedoch nicht. Der Inhalt steht fest, sobald der Lauf beendet ist, und die Schlagzeilen wurden zwei Schritte zuvor verfasst. Es gibt nichts mehr zu formulieren, nur noch zu berichten.
Genau hier verläuft die Trennlinie in der Praxis: Nicht «Text erzeugen» erfordert ein Sprachmodell, sondern «Text erzeugen, für den es keine starre Regel gibt».
Diese Zerlegung dauert auf dem Papier eine halbe Stunde: Drei Spalten für Knoten, Kanten und Zustand, gefolgt von der Frage bei jedem Knoten, ob eine einfache Bedingung genügt hätte. Diese Analyse gehört vor die Werkzeugauswahl, nicht danach.
Wer den Graphen gebaut hat
Ich habe gesagt, was entstehen soll und was es können muss. Die technische Architektur stammt von Claude: welcher Knoten ein Modell benötigt, welcher deterministisch bleibt und wo die Abbruchbedingungen liegen müssen. Anschliessend erstellte Claude den Code, also Skripte, Validierungen und Prompts.
Damit hat Claude in diesem Vorhaben zwei Rollen. Als Baumeister hat er den Ablauf entworfen und gebaut. Im laufenden Betrieb ist er der Entscheider an dem einen Knoten, der Urteil verlangt. Diese Trennung ist kein Detail: Der Baumeister arbeitete unter meiner Beurteilung, der Entscheider arbeitet ohne Eingriffe von mir.
Meine Rolle war die des Auftraggebers und Prüfers: beurteilen, ob das Konzept trägt, und die Freigabe erteilen. Getestet wurde an einer isolierten Ordnerkopie, und zwar Trockenläufe, blockierte Läufe, echte Commits mit Push, bereits publizierte Entwürfe sowie Entwürfe ohne jegliche Auswahl.
86 Läufe unter Aufsicht
Vom 2. Juni bis zum 26. August enthielt der Graph einen zusätzlichen Knoten: die menschliche Freigabe. Der Ablauf bereitete den Entwurf vor und hielt an. Ich prüfte die zwölf zweisprachigen News-Beiträge, wählte aus und löste die Publikation manuell aus. In dieser Phase entstanden 1052 News-Beiträge, von denen 550 veröffentlicht wurden.
Die Entscheidung zur Vollautomatisierung beruhte auf zwei Faktoren. Der erste ist Kapazität: Manuelle Freigabe skaliert nicht, ein Lauf pro Tag war das Maximum des Machbaren, heute laufen zwei.
Der zweite war der anspruchsvollere Teil, nämlich Vertrauen. Über 86 Läufe hinweg musste ich keine veröffentlichte Meldung zurückziehen: Die Auswahl war stimmig, die Übersetzungen präzise, die Publikationsvorschläge korrekt. Eine Automatisierung mit Aussenwirkung gibt man nicht frei, weil die Architektur auf dem Papier überzeugt, sondern weil die Ergebnisse über Monate hinweg stabil bleiben. Ein einzelner fehlerfreier Durchlauf beweist gar nichts.
Was die Automation ersetzt hat
Wenn ein Mensch einen Entwurf prüft, tut er zwei Dinge gleichzeitig: Er fängt ab, was gar nicht erst hinausgehen darf, und er beurteilt die inhaltliche Qualität. Will man diesen Kontrollschritt automatisieren, muss man beide Aufgaben aufteilen. Das Abfangen übernimmt harter Programmcode, während die Qualitätsbeurteilung über geschärfte Prompts und Leitplanken an die KI übergeben wird.
Der Kurationsauftrag an die KI wurde dafür präzisiert:
- Maximal zwölf Veröffentlichungen pro Durchlauf.
- Strikte Sperre bei Warnhinweisen zu Datum oder Dubletten.
- Jeder verworfene Eintrag erhält die Kennzeichnung «Nicht publiziert» samt einer Begründung in einem Satz.
- Grenzfall-Regel: Im Zweifel wird ein Eintrag stehen gelassen.
Die technischen Prüfungen vor und nach der Generierung übernimmt Python, kein Sprachmodell. Der Publish-Schritt bricht sofort ab, wenn:
- ein Text ein internes Stichwort enthält,
- der Staged-Diff auf ein Secret-Muster anschlägt,
- das Website-Repository offene Änderungen enthält,
- kein Fast-Forward gegen origin möglich ist.
Sollte beim Zusammenführen etwas Unerwartetes passieren, setzt ein try/except-Block alle berührten Dateien automatisch zurück.
Ergänzt wird das System durch drei Mechanismen, die den Menschen nicht ersetzen, sondern informieren. Jeder nicht publizierte Eintrag trägt seine Begründung, was eine lückenlose Spur ergibt. Nach jedem Lauf kommt der Mail-Bericht. Und ein veröffentlichtes Element lässt sich nachträglich über einen regulären Publish wieder entfernen.
Der erste Lauf ohne Freigabe ging schief
Am 26. August um 12:08 Uhr startete der erste unbeaufsichtigte Lauf und schlug fehl. Das Skript rief node ohne vollständigen Pfad auf. Unter launchd lautet der Standard-PATH /usr/bin:/bin:/usr/sbin:/sbin, während node in /usr/local/bin lag. Der vorherige manuelle Test war erfolgreich, weil er in einer Shell mit vollständiger PATH-Variable ausgeführt wurde.
Schwerwiegender als der Fehler selbst war die Folgewirkung: Die Ausnahme war nicht abgefangen worden. Die halb zusammengeführte news.json verblieb im Repository, was den darauffolgenden Lauf blockiert hätte. Ein Ausfall, der den nächsten Lauf mitreisst, ist kein temporärer Fehler mehr, sondern ein Systemstillstand.
Am 27. August fiel der Mittagslauf erneut aus, diesmal aufgrund einer Netzwerkstörung mit gescheiterter Namensauflösung aller 21 RSS-Quellen. Der Abendlauf fing den Tag problemlos auf, da das Zeitfenster für Kandidaten auf zwei Tage ausgelegt ist. Die zwei täglichen Ausführungsslots waren ursprünglich als Kapazitätsentscheidung gedacht, erwiesen sich nun aber als wirksame Ausfallsicherung.
Wann die Freigabe unverzichtbar bleibt
Dieser konkrete Ablauf darf ohne menschliches Eingreifen laufen, weil vier Voraussetzungen gleichzeitig erfüllt sind:
- Das Ergebnis ist öffentlich sichtbar und Fehler fallen sofort auf.
- Jeder Schritt ist vollständig umkehrbar.
- Es hängen weder finanzielle Mittel noch verbindliche Zusagen daran.
- Es liegen 86 überwachte Produktivläufe als Nachweis vor.
Fehlt auch nur eine dieser Bedingungen, bleibt die menschliche Freigabe zwingend erforderlich. Ein Angebot, eine Zahlung, eine Kundennachricht oder eine Änderung an kritischer Infrastruktur: Dort sind Handlungen irreversibel und die Risikoabwägung folgt völlig anderen Regeln.
Die Freigabe aus dem Code zu entfernen war die kleinere Arbeit. Die eigentliche Leistung bestand darin, vorher exakt zu verstehen, welche Aufgabe sie bisher erfüllt hatte.
Nachtrag vom 1. September: ein zweiter Knoten kam dazu
Zwei Tage nach diesem Beitrag fielen in einem Mittagslauf drei Beanstandungen an, zwei davon echte Fehler in den veröffentlichten Beiträgen. Ein Titel nannte ein Gesetz, während der eigene Fliesstext von einem Vorstoss sprach und die englische Fassung korrekt von einer bill, also einem Gesetzentwurf. Eine zweite Meldung liess offen, wer wem was verkauft: Der Titel sagte, ein Unternehmen kaufe Rechenleistung, der Text sprach von einem Dritten, der die Infrastruktur absichere. Wer nur den Beitrag las, verstand die Meldung nicht.
Beide Fehler waren am Entwurf erkennbar, ohne eine einzige Quelle zu öffnen. Genau das ist der Punkt: Der Kurator sieht sie nicht, weil er sie selbst geschrieben hat. Er kennt seine Absicht und liest sie in den eigenen Text zurück. Ein zweiter Durchgang desselben Modells im selben Kontext hätte daran nichts geändert.
Der neue Knoten bekommt deshalb einen frischen Kontext und sieht nur, was ein Leser sieht: den fertigen Beitrag. Er prüft vier Dinge, Konsistenz zwischen Titel und Text, Verständlichkeit ohne die Quelle, Übereinstimmung der beiden Sprachfassungen und Relevanz für den Mittelstand. Er darf zurückweisen, aber nicht umschreiben. Wer prüft und zugleich schreibt, beurteilt am Ende den eigenen Text.
Gegen den fehlerhaften Entwurf gemessen, fand er beide Fehler und liess die übrigen fünf Beiträge durch. Ein Ergebnis fehlt in dieser Bilanz: Der dritte beanstandete Punkt war gar keiner. Der Quellenname mit dem Tippfehler stammte nicht aus unserem Ablauf, sondern ist die tatsächliche Domain des Verlegers. Nachgemessen, statt korrigiert.
Eine Grenze zeigte die Messung ebenfalls. Bei den drei harten Kriterien urteilt der Knoten stabil, beim weichsten nicht: Relevanz ist Ermessen, und derselbe Beitrag fiel in einem Lauf durch und im nächsten nicht. Das ist der Preis dafür, ein Urteil an ein Modell zu geben, und er ist hier tragbar, weil die Folge einer Fehlentscheidung ein nicht publizierter Beitrag ist und kein falscher.
Fällt der Prüf-Knoten selbst aus, wird nichts publiziert. Das ist die unbequemere von zwei Möglichkeiten. Die andere wäre, im Zweifel durchzuwinken, und dann wäre der Riegel beim ersten Ausfall wirkungslos, ohne dass es jemand merkt. Ein Riegel, der still aufhört zu prüfen, ist schlimmer als keiner.
Was ohne KI nicht entstanden wäre
Es ist undenkbar, dass ich diesen Ablauf ohne KI gebaut hätte. Betreiben könnte ich ihn erst recht nicht. Beides wäre nicht an der Idee gescheitert, sondern an meiner Zeit und am fehlenden Know-how, Python und Skripte selbst zu programmieren.
Genau darin liegt der Punkt von Graph Engineering mit KI: Es geht nicht nur darum, bestehende Abläufe zu beschleunigen. Es entstehen Abläufe, die vorher gar nicht möglich waren.
Welche Geschäftsvorfälle in Ihrem Betrieb liessen sich auf diese Weise verbessern, und welche würden überhaupt erst möglich?